Expresiones regulares
Las expresiones regulares sirven para hacer operaciones de "buscar" y de "bucar y reemplazar" de un forma sofisticada. En Unix, donde casi todo son ficheros de texto, es una herramienta casi imprescindible, no tan solo de cara al administrador, sino también de cara a cualquier usuario o programador.
Imaginemos un cliente que pide una modificación para su página web que nosotros administramos, y quiere que todo lo que hasta ahora era cursiva se vuelva negrita, pero solo si el contenido de la frase usa una palabra clave. Pensemos este problema en Word: buscamos una frase que contenga la palabra "clave", miramos si está entre las etiquetas <i></i> y en caso afirmativo, reemplazamos <i></i> por <b></b>. Pues para problemas de este tipo se inventaron las expresiones regulares.
Una expresión regular es un patrón que describe un conjunto de cadenas. Las expresiones regulares se construyen de manera análoga a las expresiones aritméticas, mediante el uso de diversos operadores que combinan expresiones más pequeñas. Los filtros de la familia grep entienden tres sintaxis diferentes de expresiones regulares: básica (BRE), extendida (ERE) y perl (Perl). Nosotros nos vamos a centrar en estos momentos en las dos primeras.
Las expresiones regulares se utilizan en:
- operaciones de comparación.
- búsquedas o sustituciones de gran complejidad.
Una expresión regular no es más que una cadena de texto (patrón) en la que distinguimos dos tipos de caracteres:
- Caracteres ordinarios: Solo concuerdan con ellos mismos.
- Caracteres especiales (metacaracteres): Tienen un significado especial para el programa que los interpreta. Si queremos convertirlos en caracteres ordinarios debemos escribirlos en la expresión regular precedidos de la barra invertida (\*, \[, \^, \$, etc.).
Hay caracteres especiales que tienen un significado especial independientemente del lugar dentro del patrón donde aparezcan (*, [, etc.). Sin embargo, hay otros que solo tienen un significado especial cuando se sitúan en una posición determinada; el carácter ^ es especial si va al comienzo de la expresión regular y el carácter $ solo cuando va al final.
A continuación vamos a ver todos los caracteres especiales de las BRE y su significado:
| R1R2 | Esto es la concatenación, la operación más común de las expresiones regulares. Dos expresiones regulares pueden concatenarse, la expresión regular resultante concuerda con cualquier cadena formada por la concatenación de dos subcadenas que casan con R1 y R2 respectivamente. La concatenación más básica es la de caracteres ordinarios, por ejemplo, la expresión regular "ab" está compuesta por la concatenación de las expresiones regulares "a" y "b", y en este caso solo coincide con la cadena de texto "ab". |
Gráficamente podemos mostrar el proceso de evaluación de la expresión regular "ada" sobre el texto "Cascada alta" que llevaría a cabo un comando que trabaje con expresiones regulares como grep:
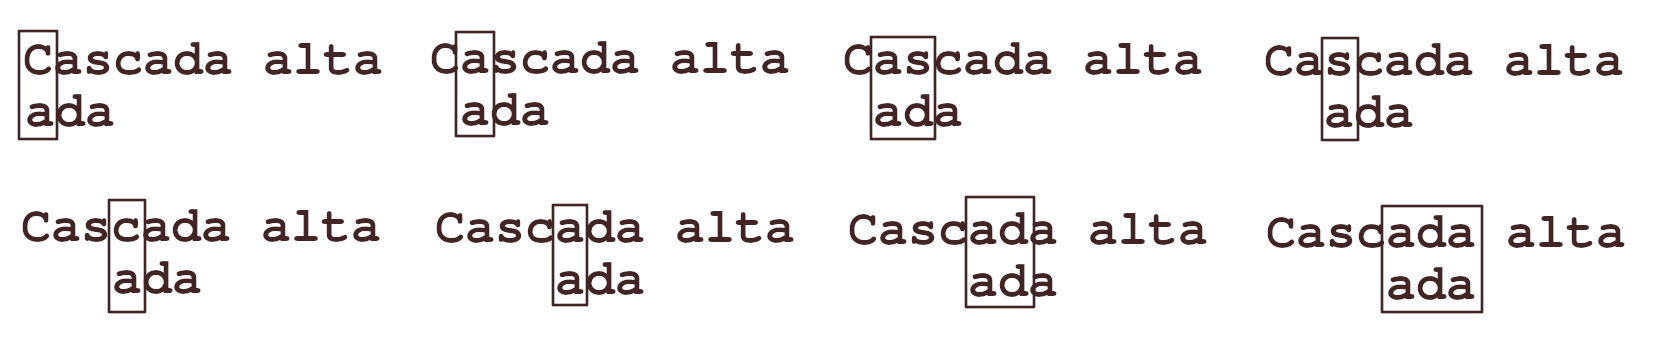
Las expresiones regulares distinguen entre mayúsculas y minúsculas y se busca la coincidencia en el texto de izquierda a derecha.
| . | El carácter punto concuerda con cualquier carácter excepto con el carácter de fin de línea (\n). Sería equivalente al carácter ? en la expansión de ficheros. Usando la concatenación, vista anteriormente, podemos crear una expresión regular que concuerde con dos caracteres cualesquiera, esta sería "..", donde los textos "de" o "==" casan con dicho patrón. |
| [lista] |
Los corchetes concuerdan con un único carácter cualquiera de los presentes en la lista o de los ausentes si la lista comienza por el carácter ^, y nunca con el fin de línea (\n). Por ejemplo: [0123456789] coincide con un dígito y [^0123456789] coincide con cualquier carácter que no sea un dígito. Dentro de los corchetes también se puede especificar un rango mediante la colocación de dos caracteres separados por un guión. Por ejemplo, las dos expresiones regulares anteriores son equivalentes a las dos siguientes, respectivamente: [0-9] y [^0-9]. Los dos caracteres que definen el rango deben ir ordenados de menor a mayor, es decir, la expresión regular [9-0] sería incorrecta. Este orden se entiende dentro de la codificación que esté configurada, normalmente utf-8. Ciertas listas de caracteres se usan mucho, por lo que ya están creadas y se les ha dado un nombre:
No debe olvidarse que el nombre de estas listas de caracteres incluyen los corchetes, por lo que para crear una lista a partir de listas con nombre hay que duplicar los cochetes, por ejemplo: [[:alnum:][:punct:]] Para incluir el ] en la lista, se debe poner el primero, para el ^ lo pondremos en cualquier sitio menos al principio, y por último, para incluir el - lo pondremos el último o el primero de la lista: Por ejemplo: []^-] Los rangos y las listas se pueden mezclar: [a[:digit:]x-z^] Los caracteres especiales de las expresiones regulares se comportan como caracteres ordinarios dentro de una lista. Una lista interesante son las clases de equivalencia que tienen la siguiente sintaxis: [=c=], donde c es un carácter cualquiera. En español, por ejemplo, existen varias formas de escribir la letra a, pues esta puede llevar distintos tipos de tíldes, con la clase de equivalencia [=a=] estamos construyendo la lista [aáàâä] de forma mucho más cómoda. |
| R* |
El carácter especial * concuerda con cero o más repeticiones de la expresión regular que le precede (R). La expresión regular más básica es un carácter ordinario, y por lo tanto "a*", casa con "a", "aa", y cualquier cantidad de aes consecutivas, incluida cero aes, por lo tanto, casa también con la cadena nula. El papel de la cadena nula se puede ver mejor en la expresión regular "ab*", esta expresión es la contatenación de las expresiones "a" y "b*", debido a que el * tiene más prioridad que la concatenación, si no fuese así, el * se aplicaría a la expresión "ab". Teniendo en cuenta todo esto, las cadenas "ab", "abb", "abbb", etc., casarán con "ab*", pero también casa la cadena "a", pues "b*" incluye cero repeticiones de la b, es decir, la cadena nula. Una expresión como ".*" casa con cualquier secuencia de caracteres incluido la cadena nula, en cambio, "..*" casaría con cualquier secuencia de caracteres. La evaluación de todos los operadores de repetición, el * y los que veremos más adelante, siempre se hará buscando el texto más largo que pueda coincidir, por lo que con un texto como "abcccd" y una expresión "bc*", a esta se le hará coincidir con la cadena "bccc" y no con otra más corta como "b", "bc" o "bcc", que en principio también casan con la expresión regular. |
| ^R | Solo tiene significado especial cuando es el primer carácter de la expresión regular. Concuerda con el comienzo de la línea, por lo tanto, se estaría diciendo que lo que vaya a continuación del carácter ^ debe estar al principio de la línea para que concuerde el patrón. La expresión regular "^ *" (hay dos espacios entre los símbolos ^ y *) casaría con uno o varios espacios consecutivos al inicio de una línea. |
| R$ | Solo tiene un significado especial cuando es el último carácter de la expresión regular. Concuerda con el final de la línea, por lo tanto, se estaría diciendo que lo que esté antes del $ debe estar al final de la línea para que concuerde el patrón. La expresión regular "\.$" concuerda con el carácter punto siempre que esté en el final de una línea. |
| \w | Es equivalente a cualquiera de los caracteres que constituyen una palabra, o lo que es lo mismo, cualquier carácter de la lista [_[:alnum:]]. El patrón "^\w" casaría con el primer carácter de palabra (alfanumérico o _ ) que se encuentre al inicio de una línea. |
| \W | Es el complementario de \w, es decir, cualquier carácter que no constituye una palabra. Es equivalente a [^_[:alnum:]]. |
| \b |
Concuerda con el límite de un palabra, por el inicio o por el final. Se puede decir también que casa con la cadena nula que hay entre un carácter no palabra (\W) y un carácter palabra (\w), y al la inversa, la cadena nula entre un carácter palabra (\w) y otro no palabra (\W). La expresión regular "\bA", casa con la vocal a mayúscula que va al inicio de una palabra. El patrón "\bLa\b" casa con el texto "La" siempre que contituya una palabra independiente, por ejemplo en "La cocina" y no en "Lavabo". |
| \B | Es el complementario de \b. Casa en cualquier sitio que no sea el inicio ni el final de una palabra, es decir, es la cadena nula comprendida entre dos caracteres palabra (\w) o dos caracteres no palabra (\W). La expresión regular "\bLa\B" casa con el texto "La" en "Lavabo", pero no en "La cocina". |
| \<R | Concuerda con el inicio de una palabra. Equivalente a \bR. |
| R\> | Concuerda con el final de una palabra. Equivalente a R\b. |
| \s | Casa con un carácter espacio o tabulación (\t). |
| \S | Es el complementario de \s, por lo tanto casa con cualquier carácter que no sea espacio o tabulación (\t). |
| R\+ | El metacarácter \+ concuerda con una o más repeticiones de la expresión regular que le precede. La expresión regular anterior "..*" es equivalente a ".\+". |
| R\? |
El metacarácter \? casa con una o ninguna ocurrencia de la expresión regular que le precede. La expresión regular "cocinas\?" concuerda tanto con "cocina" como con "cocinas". |
| R\{n\} |
El metacarácter \{n\} sirve para indicar n repeticiones exactas de la expresión regular R. |
| R\{,n\} |
Para indicar entre 0 y n repeticiones de la expresión regular R. |
| R\{n,\} |
Para indicar n o más repeticiones de la expresión regular R. |
| R\{n,m\} |
Para indicar entre n y m repeticiones de la expresión regular R. |
| R1\|R2 |
Con el operador \| conseguimos proponer una alternativa entre dos expresiones regulares o más si se repite el operador. La búsqueda de la coincidencia se realiza por orden y de izquierda a derecha, deteniéndose en la primera expresión regular que concuerde. |
| \(R\) |
Los operadores \( y \) funcionan como los paréntesis en las expresiones aritméticas, es decir, permiten alterar la prioridad del resto de los operadores (esta se especifica más abajo en esta página), podemos verlo en con las dos siguientes expresiones regulares, "ab\+" y "\(ab\)\+", la primera casa con cadenas como "ab", "abb", "abbb", etc., y la segunda con "ab", "abab", "ababab", etc., y esto se debe a el operador \+ tiene más prioridad que la concatenación, y eso se altera en la segunda expresión regular, haciéndose que la concatenación se realice antes que la repetición. Pero los operadores paréntesis tienen una segunda función en las expresiones regulares y es la de crear subexpresiones regulares con el objetivo de referirnos posteriormente al texto que concuerda con ellas, y utilizarlo tanto en la misma expresión regular de búsqueda, como en la cadena de sustitución en aquellos contextos donde usamos las expresiones regulares para buscar y sustituir texto. Se va a entender esto mejor, viendo la siguiente entrada de esta tabla, donde se explica cómo referirnos al texto que ha casado con una subexpresión. |
| \n |
Este operador se llama retroreferencia (back-reference), y como su propio nombre indica, sirve para hacer referencia a un trozo de la expresión regular que se encuentra a la izquierda de la referencia. Dicho trozo de la expresión regular se llama subexpresión y se construye con los operadores paréntesis. Realmente la retroreferencia representa al texto que concuerda con la subexpresión. El valor de n debe estar comprendido entre 1 y 9, que se corresponde con el orden de aparación de las subexpresiones de izquierda a derecha. No pueden crearse más de 9 subexpresiones dentro de una misma expresión regular. Veamos un ejemplo donde usaremos la retroreferencia dentro de la propia expresión regular. Supongamos que queremos buscar líneas que comienzan por una vocal en minúscula y terminan con la misma vocal en minúscula. Para esta situación utilizaríamos la siguiente expresión regular: "^\([aeiou]\).\*\1$". Como vemos, hemos hecho una subexpresión para la vocal del inicio de la línea y nos referimos a esa misma vocal posteriormente en la expresión regular con una retroreferencia (\1) para que coincida al final de la línea. Hay otro contexto donde podemos usar las retroreferencias, y es en las operaciones de buscar y reemplazar empleando expresiones regulares. La orden sed permite este tipo de operaciones a través de su comando s, el cual incluye una expresión regular para buscar y un texto para sustituir. Se puede crear una subexpresión en la parte de búsqueda y utilizar una retroreferencia en la parte de sustitución, por ejemplo, si pretendemos cambiar todas las etiquetas <i> por <em> en una página web, el comando s de sed quedaría asi: "s/<i>\(.*\)<\/i>/<em>\1<\/em>/g". La expresión regular de búsqueda es "<i>\(.*\)<\/i>", donde hemos creado una subexpresión equivalente a todo el contenido entre las etiquetas <i> y </i>. Por otro lado, el texto de sustitución es "<em>\1<\/em>", y es aquí donde hemos usado la retroreferencia (\1) para colocar dentro de las etiquetas <em> y </em> el mismo contenido que estaba dentro de <i> y </i>. |
La prioridad de los operadores que hemos visto, de mayor a menor, es la siguiente:
- R*, R\+, R\?, R\{
- R1R2
- R1\|R2
Algunos ejemplos de BRE son los siguientes:
| Patrón | Coincide con |
| a.b | aXb aab abb a$b a9b ... |
| a..b | aXXb aaab abbb aabb a6;b ... |
| [abc] | a b c |
| [aA] | a A |
| [aA][bB] | ab aB Ab AB |
| [A-Za-z] | A B C ... Z a b c ... z, pero con la codificación de español incluiría también las vocales con tildes, es decir, A Á À Â Ä B C ... Z a á à Â ä b c ... z |
| [0-9][0-9][0-9] | 000 001 ... 009 010 ... 019 100 ... 999 |
| [0-9]* | cadena vacía, 0 1 9 00 99 123 456 999 9999 ... |
| [0-9][0-9]* | 0 1 9 00 99 123 456 999 9999 99999 99999999 ... |
| ^.*$ | cualquier línea, incluida la vacía, la que solo lleva el carácter de nueva línea (\n). |
| [0-9]\+ |
0 1 9 00 99 123 456 999 9999 99999 99999999 ... |
| [0-9]\? |
cadena vacía, 0 1 2 .. 9 |
| ^a\|b | una a al comienzo de línea ó una b. |
| \([0-9]\+ab\)* | cadena vacía, 1234ab 9ab9ab9ab 99ab957ab ... |
Las ERE tiene los mismos metacaracteres que las BRE, la diferencia está en que algunos caracteres especiales se escriben directamente sin el símbolo \, si no, estaríamos haciendo referencia a un carácter ordinario.
| Sintaxis | Significado en las BRE | Significado en las ERE |
| \+ |
Una o más repeticiones. |
Carácter ordinario +. |
| + |
Carácter ordinario + | Una o más repeticiones. |
| \? |
Cero o una repetición. |
Carácter ordinario ?. |
| ? |
Carácter ordinario ?. |
Cero o una repetición. |
| \{ y \} |
Repeticiones. |
Carácter ordinario { y }. |
| { y } |
Carácter ordinario { y }. |
Repeticiones. |
| \| |
Alternativa de expresiones regulares. |
Carácter ordinario |. |
| | |
Carácter ordinario |. |
Alternativa de expresiones regulares. |
| \( y \) |
Subexpresión. |
Carácter ordinario ( y ). |
| ( y ) |
Carácter ordinario ( y ). |
Subexpresión. |
Usar una u otra sintaxis, lo decidimos nosotros, en un caso donde estemos buscando una expresión regular que incluya carácteres + por ser una fórmula matemática, quizás sea más interesante usar el + como carácter ordinario, y por lo tanto usaríamos la sintaxis BRE, pero si en la expresión regular no aparecen caracteres ordinarios +, quizás sea más cómodo usar la sintaxis ERE, pero nosotros decidimos.
Algunos ejemplos de ERE:
| Patrón | Coincide con |
| [0-9]+ | 0 1 9 00 99 123 456 999 9999 99999 99999999 ... |
| [0-9]? | cadena vacía, 0 1 2 .. 9 |
| ^a|b | una a al comienzo de línea ó una b. |
| (ab)* | cadena vacía, ab abab ababab ... |
| ^[0-9]?b | b 0b 1b 2b .. 9b, cualquiera de lo anterior pero al comienzo de una línea. |
| ([0-9]+ab)* | cadena vacía, 1234ab 9ab9ab9ab 99ab957ab ... |
Licencia: licencia de software libre GPL